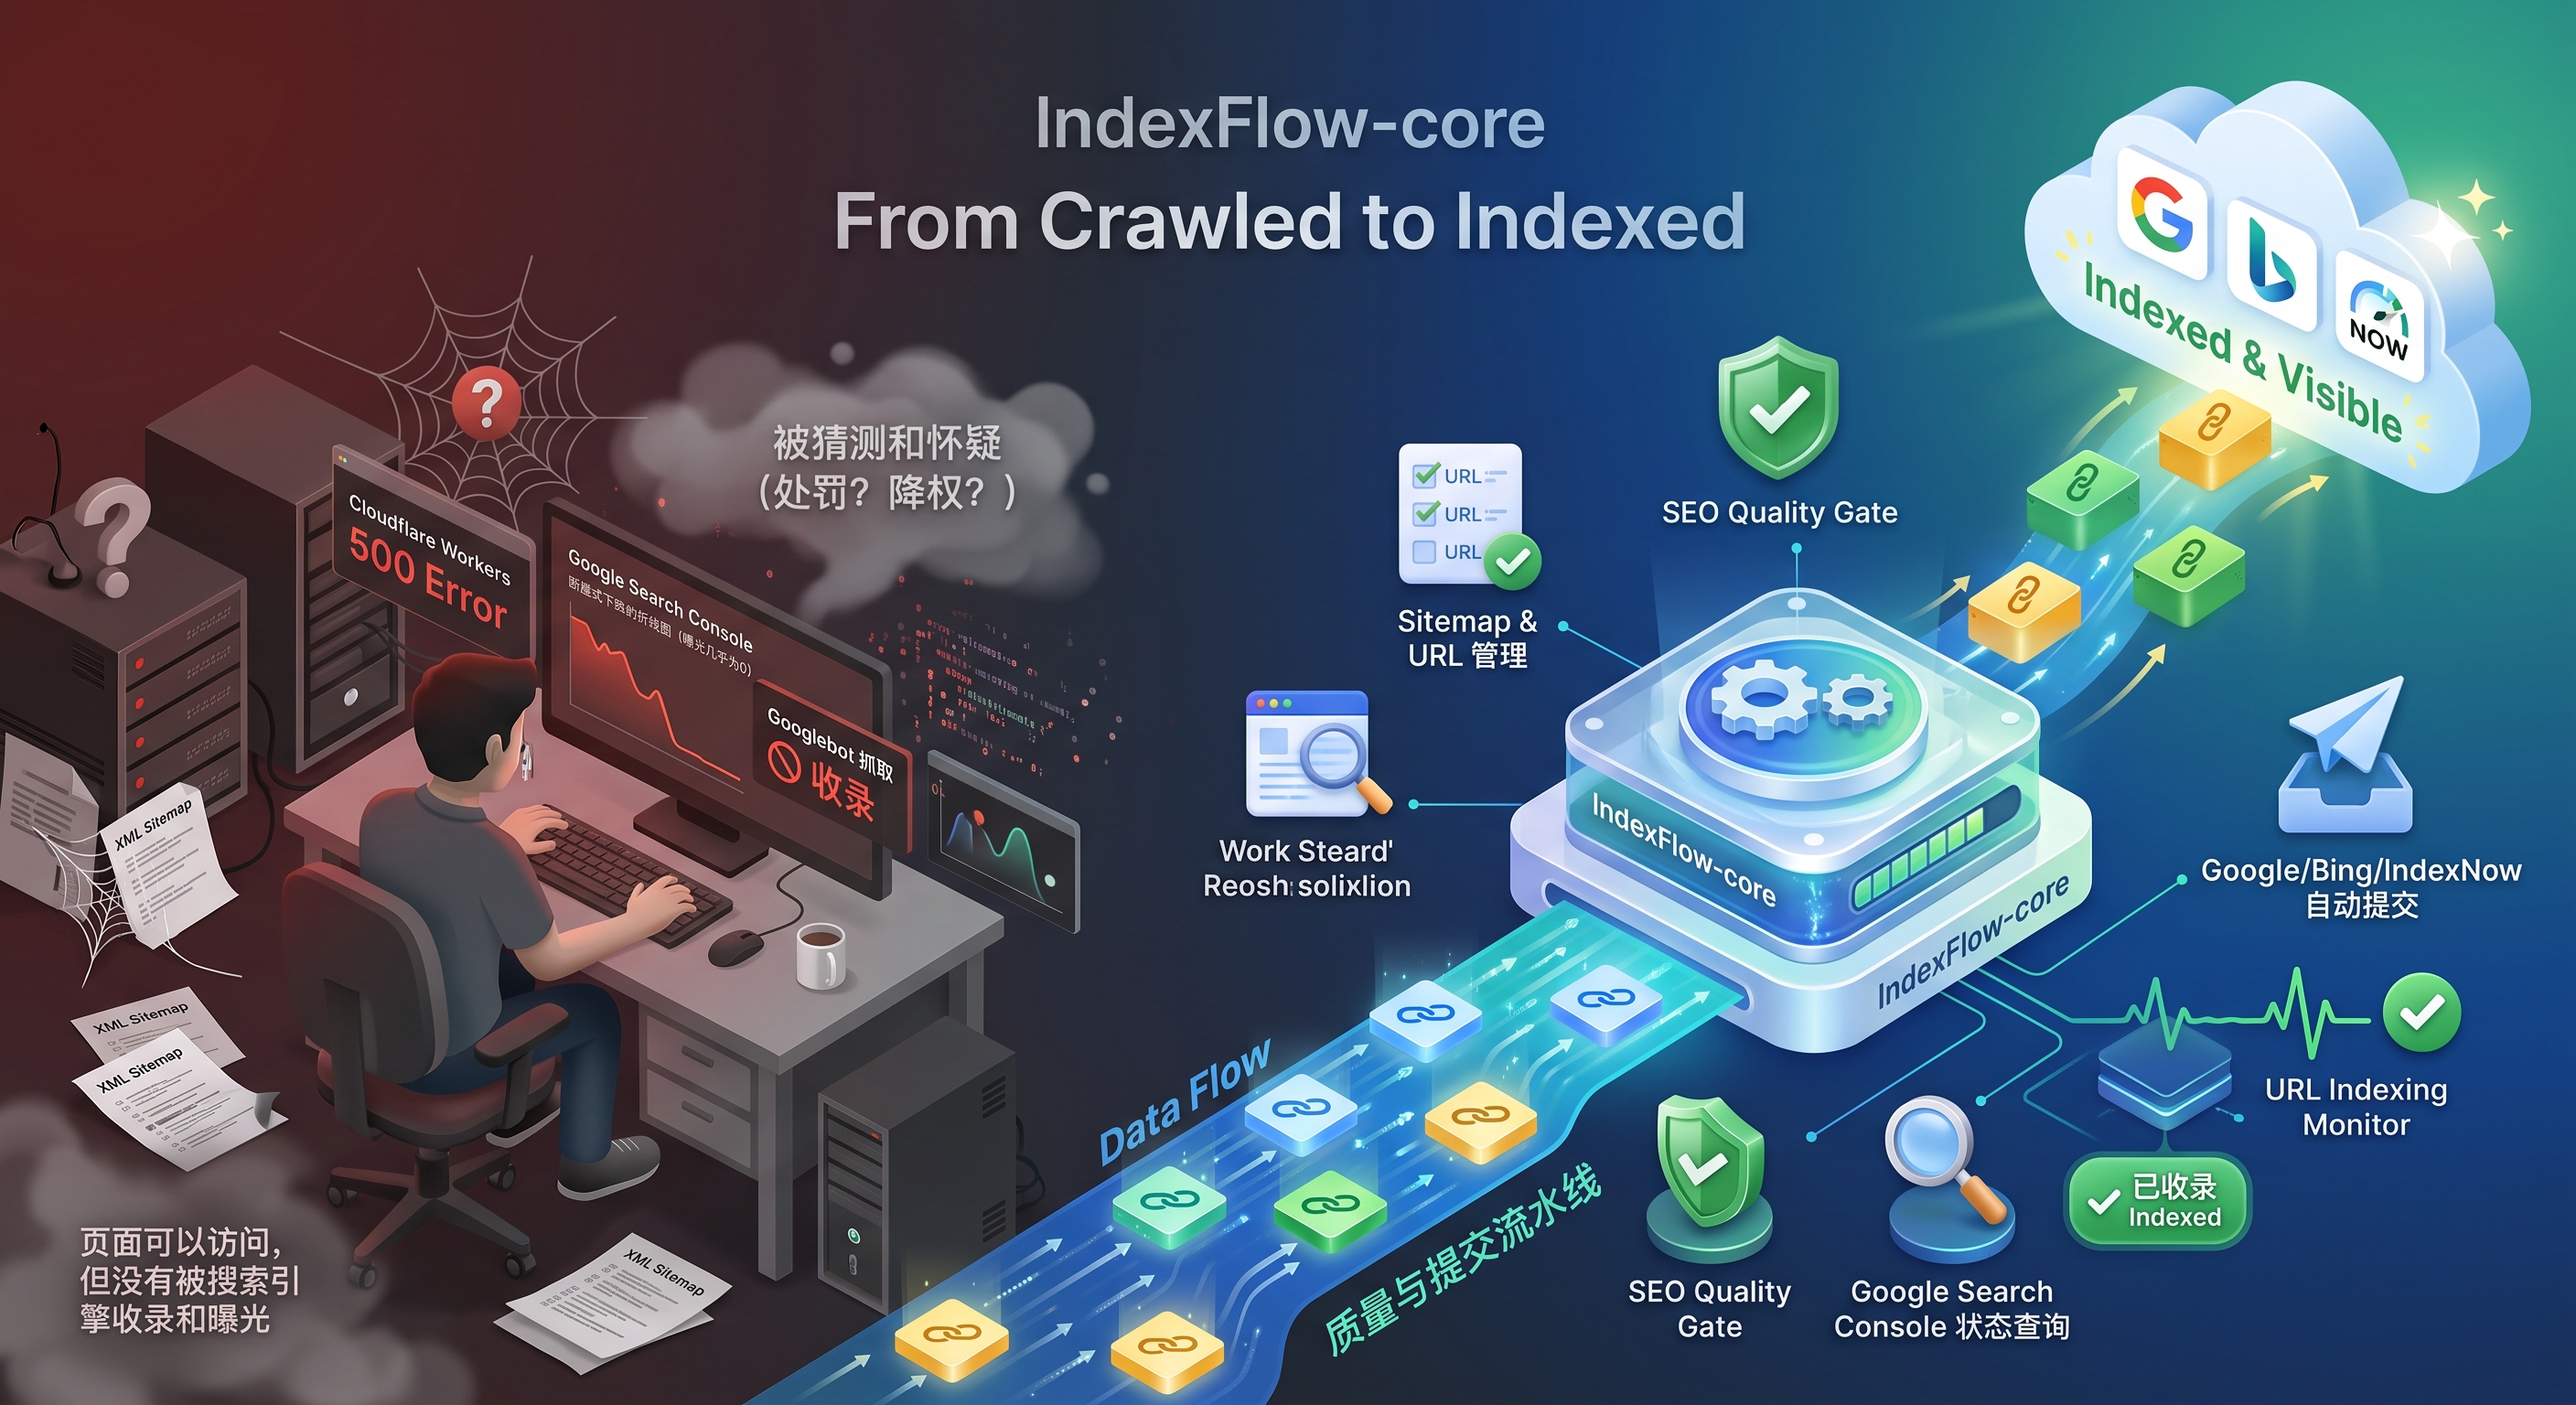
这个项目不是从一个“我想做一个 SEO 工具”的想法开始的。
它开始于一次真实的网站事故,以及一个后来一直困扰我的问题:我怎么知道一个 URL 到底有没有被搜索引擎正确理解、抓取和收录?
一个看起来进展顺利的网站
6 月中下旬,我上线了一个由 AI 构建的资源网站。网站的 URL 数量很多,同时提供多种语言版本,因此从一开始,我就知道搜索引擎流量会是它非常重要的一部分。
刚上线的时候,一切看起来都不错。Google 能够正常抓取页面,也开始逐步收录。到 7 月初,Google 给出的抓取预算一度达到每天大约 12 万次。对于一个刚上线不久的独立项目来说,这个信号相当令人兴奋:至少搜索引擎正在发现它、访问它。
但问题很快出现了。
从 Cloudflare Workers 的 500 错误开始
后来我发现,网站运行在 Cloudflare Workers 上时,受到了 50ms CPU 时间限制的影响。部分请求无法在限制内完成,最终产生了大量 500 错误。
这不只是一个普通的运行时问题。搜索引擎访问到的是错误页面,原本应该被稳定访问的 URL 变得不稳定。抓取预算、服务器响应和页面可用性之间开始互相影响。
我随后把网站迁移到了服务器上,希望先解决稳定性问题。服务器确实缓解了 Workers 的限制,但新的问题又出现了:前后端分离的维护复杂度很高。为了修复一个问题,往往要同时检查接口、渲染、部署和不同语言页面之间的关系。
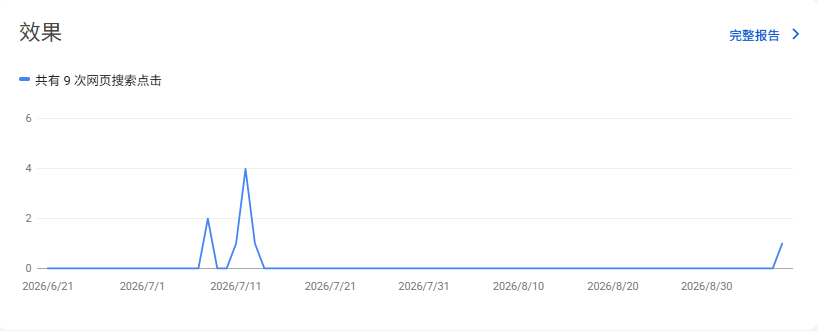
在这段迁移和维护过程中,Google 的收录和曝光出现了断崖式下降,最后几乎接近 0。
我曾经以为是 Google 惩罚了网站
当一个网站的抓取和曝光突然归零时,人很容易先寻找一个简单的解释。
是不是被 Google 惩罚了?是不是被封禁了?是不是网站的某些内容触发了 Sandbox?是不是 AI 构建的网站天然不被信任?
我花了不少时间研究 SEO、Google Search Console 的数据、抓取行为、索引状态和各种可能的原因。这个过程没有一个立刻能让人安心的答案,因为“页面可以访问”“Google 抓取过页面”和“页面出现在搜索结果里”,其实是三件不同的事情。
这也是我后来反复确认的一点:
被抓取,不等于被收录;被收录,也不等于能够获得曝光。
如果只看服务器日志,知道 Googlebot 访问过某个 URL,可能会误以为这条 URL 已经完成了 SEO 工作。但实际情况可能是:页面返回过错误、质量检查没有通过、搜索引擎暂时没有把它加入索引,或者它已经收录却没有获得有效排名。
我真正缺少的不是更多猜测,而是持续验证
在这次经历之前,我会通过不同工具零散地检查网站:看 Sitemap 是否生成、打开页面确认内容、在 Search Console 里手动查询、需要时再提交 URL。
这些动作单独看都不难,但它们没有形成一条持续的验证链。我缺少一个能够回答下面这些问题的工具:
- Sitemap 中有哪些 URL,它们当前是否符合预期?
- URL 的 SEO 基础质量是否达标?
- Google Search Console 认为某个 URL 的索引状态是什么?
- 一个 URL 是否已经提交给 Google、Bing 或 IndexNow?
- Google 抓取过的 URL,什么时候才真正进入索引?
于是我开始开发 IndexFlow-core。
IndexFlow-core 是什么?
IndexFlow-core 是一个开源的搜索引擎索引基础设施。
它关注的不是某个页面如何写标题,也不是承诺用一个技巧让网站排名上升。它要解决的是更基础、更容易被忽略的一层:让网站能够持续管理 URL,验证 URL 的 SEO 状态,了解搜索引擎反馈,并在需要时提交页面。
目前它的核心能力主要包括以下五项。
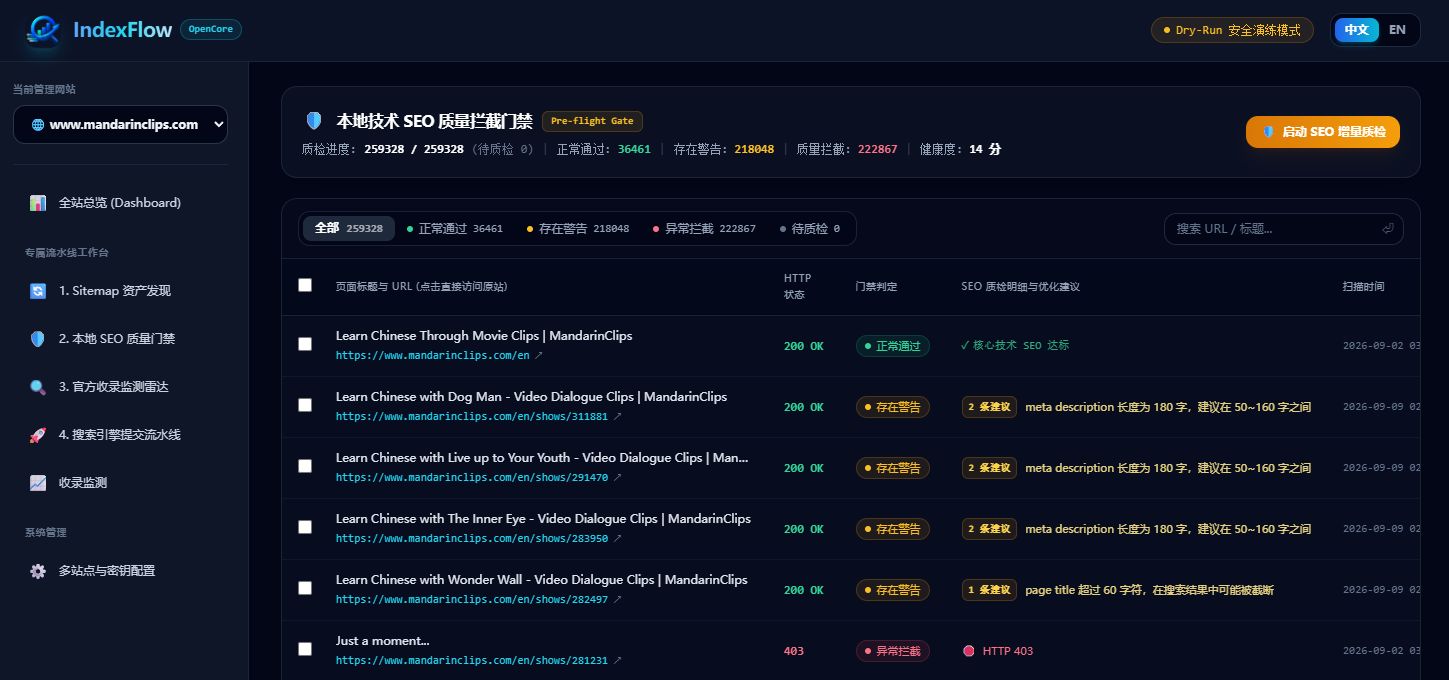
1. Sitemap 和 URL 管理
把网站的 URL 作为可以管理和检查的对象,而不是只把 Sitemap 当成部署时顺手生成的一份 XML 文件。这样可以更清楚地知道哪些 URL 应该被发现、哪些 URL 需要进一步检查。
2. SEO Quality Gate
在 URL 进入后续索引流程之前,先进行 SEO 质量检查。它的作用是尽早发现页面基础信息和可索引性方面的问题,避免把明显不完整或不符合预期的 URL 直接交给搜索引擎。
3. Google Search Console 收录查询
通过 Google Search Console 查询 URL 的索引状态,区分“我认为页面已经上线”和“Google 对这个 URL 的实际判断”。这让收录问题从猜测变成可以持续追踪的状态。
4. Google、Bing 和 IndexNow URL 提交
为不同搜索引擎提供 URL 提交能力,覆盖 Google、Bing 和 IndexNow。提交不是收录保证,但它可以让网站在有明确更新或需要主动通知时,拥有更直接的入口。
5. URL Indexing Monitor
最近新增的 URL Indexing Monitor,是我在继续使用这个项目后发现非常需要的一项能力。它可以持续监控 URL 的索引状态,帮助判断一个页面什么时候真正被收录,而不是只记录它什么时候被抓取或提交。
为什么还要做 URL Indexing Monitor?
最近 Google 的抓取逐渐恢复到了每天大约 3K。乍看之下,这是一个好消息:Google 又开始访问网站了。
但这次我没有像之前那样,把抓取量直接当作成功信号。因为我已经知道,抓取和收录不是一回事。
Google 访问了一个 URL,只能说明它被发现并请求过。这个 URL 是否通过了质量判断、是否进入索引、之后是否能在搜索结果中获得曝光,还需要另外验证。如果没有监控,我们很容易在“Googlebot 来过”这里过早结束判断。
所以我把 URL Indexing Monitor 加进了 IndexFlow-core。它不是为了制造更多数据,而是为了补上索引流程中最关键的一段:从“被抓取”到“真正被收录”之间的观察。
为什么决定开源?
IndexFlow-core 源于我自己的真实问题。我遇到过 500 错误、迁移和维护复杂度,也经历过收录和曝光接近归零时的怀疑与反复排查。
现在我仍然在持续使用它,也仍然在根据真实网站的数据和问题迭代功能。对我来说,它不是做完一次就结束的项目,而是一套会随着网站和搜索引擎状态继续变化的基础设施。
正因为它先服务于一个真实存在的工作流,我希望把它开源出来,让更多需要管理大量 URL、关注 SEO 质量和搜索引擎收录状态的人可以使用、反馈和一起改进。
后续我会继续围绕 URL 的可见性、索引状态和验证流程迭代 IndexFlow-core。这个项目的起点是一场 Google 收录危机,但它最终想解决的,是一个更长期的问题:不要再凭感觉判断网站是否被搜索引擎正确理解,要能够持续验证。